pipeline پربازده برای تحلیل ژنوم باکتریهای مورد استفاده در تولید مواد غذایی
A Bacillus subtilis سویه ای که از bekang غذایی تخمیر شده سنتی هندی جدا شده است، از نظر فیلوژنتیکی با سویه های natto ژاپنی متمایز است اما مجموعه ای نزدیک از ژن های کمکی را به اشتراک می گذارد. این مطالعه همچنین یک مسیر ژنومیک مقایسه ای کارآمد برای باکتری های مورد استفاده در تولید غذا ارائه داد.
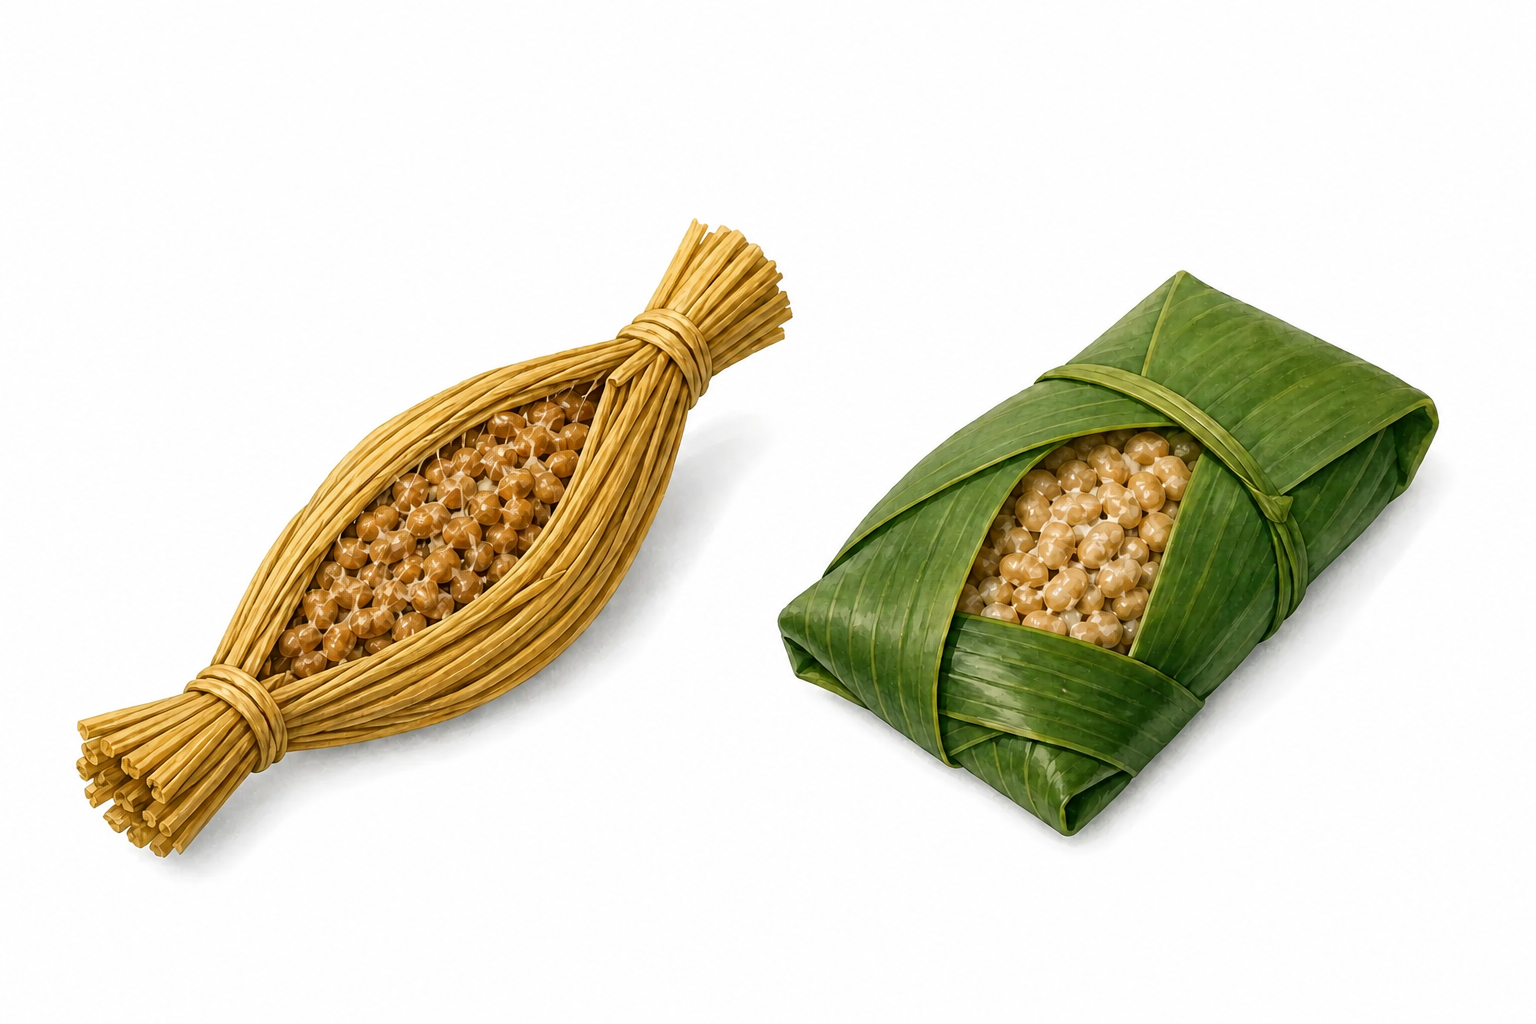
اطلاعات مقالهٔ پژوهشی اصلی
نویسندگان: Kiyohiko Seki & Yukio Nagano
مجله: Scientific Reports
تاریخ انتشار: ۱۷ دسامبر ۲۰۲۵ (پذیرفتهشده در ۱۸ نوامبر ۲۰۲۵)
DOI: 10.1038/s41598-025-29683-y
شاخصهای مجله: 2025 Journal Impact Factor: 4.9; 2025 5-year Journal Impact Factor: 4.8; 2025 SNIP: 1.339; 2025 SJR: 0.893; دومین مجلهٔ پراستناد جهان (تازهترین شاخصهای اعلامشده از سوی ناشر تا ژوئیهٔ ۲۰۲۶)
نوع مقاله: دسترسی آزاد (Open Access)
برای بررسی تنوع Bacillus subtilis مورد استفاده در تخمیر مواد غذایی، ابتدا 55 genome گردآوری شد و در تحلیلهای اصلی pangenome و ژنومیک مقایسهای، 42 strain دارای quality control وannotation یکسان بهکار رفت.
پیشینه و یافتههای اصلی
برای مرور کلی و آشنایی با داستان این کشف، به پیوندهای زیر مراجعه کنید:
- Press Release: Japanese “Natto” and Indian Traditional Food “Bekang” Bacteria: Genetically “Strangers” yet “Identical Twins”!?
- داستان پژوهش: The Global “Natto” Connection (Springer Nature Research Communities)
تحلیل اصلی، 26 isolate ژاپنی natto را narrow-sense natto group تعریف کرد. یک isolate از غذای سنتی هند، bekang (Food_IND_1)، در core-genome phylogeny بیرون از natto clade قرار داشت، اما بر پایهٔ Jaccard distance حاصل از presence/absence ژنهای accessory نزدیکترین همسایهٔ عملکردی آن بود. مجموع 27 strain بهعنوان broad-sense natto group مقایسه شدند. Horizontal gene transfer (HGT) وselective retention توضیحهای محتملاند، نه سازوکارهایی که مستقیما در این مطالعه اثبات شده باشند. تفسیرهای عملکردی عمدتا بر annotation وenrichment analysis تکیه دارند، نه phenotyping مستقیم چند isolate از bekang؛ بنابراین مقایسهٔ bekang یک n=1 case study است.
workflow ژنومیک مقایسهای
workflow ژنومیک مقایسهای، گردآوری public data، genome assembly، quality control وannotation را با pangenome analysis و مقایسهٔ phylogeny وgene content یکپارچه میکند.
- آمادهسازی داده: raw reads و سوابق ژنوم عمومی با روشهای یکسان assembly، quality control وannotation پردازش شدند.
- مقایسهٔ phylogeny وgene content: core-genome phylogeny با Jaccard-distance clustering مبتنی بر presence/absence ژنهای accessory ترکیب شد.
- تحلیل تفاوتهای نامزد: synteny، phylogenetic networks و ژنهای اختصاصی هر گروه برای مقایسهٔ تفاوتهایی مانند indels، transposons، gene duplications وtruncations بررسی شدند.
دامنهٔ شواهد و کاربردهای احتمالی
شواهد، روابط ژنومی و candidate genes را مشخص میکنند. کاربرد آنها در عملکرد تولید، طعم، ایمنی یا کنترل کیفیت به phenotyping، آزمایشهای fermentation، آزمون reproducibility وvalidation در محیط تولید نیاز دارد.
- کاربرد احتمالی: workflow میتواند مقایسهٔ strainها و تدوین فرضیه دربارهٔ ژنها یا gene setهای مرتبط با phenotype را پشتیبانی کند.
- نیاز به validation: تنها با sequence data نمیتوان عملکرد strain، کیفیت محصول یا آلودگی را مستقیما تشخیص داد؛ validation آزمایشگاهی و در سطح تولید ضروری است.
ما از همکاری هایی که ژنوم های غذایی-میکروارگانیسم را با داده های فنوتیپی و تخمیر ترکیب می کنند تا دامنه معتبر این روند تطبیقی ژنومیک را آزمایش کنند، استقبال می کنیم.
جمعبندی
با ترکیب core-genome phylogeny وaccessory-gene composition، مطالعه یک comparative-genomics workflow پربازده برای شناسایی شباهت میان strainهای از نظر تبارزایی متمایز B. subtilis ارائه کرد. نتیجهٔ bekang یک n=1 case study است و فرضیههای عملکردی آن به اعتبارسنجی بیشتر نیاز دارند.